
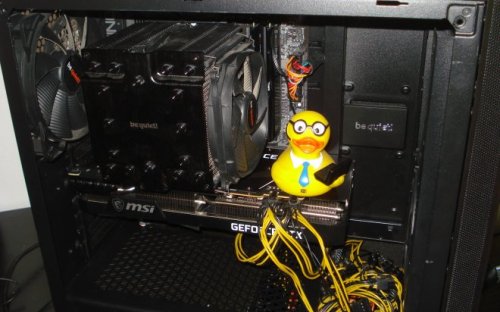
LLMs können hilfreich sein beim Programmieren, Fehler finden, Texte verbessern oder übersetzen. Doch möchte ich nicht alle meine Fragen an einen KI Anbieter wie OpenAI, Google, Anthropic oder Alibaba senden. Nun habe ich einen PC zusammengebaut der KI quasi mit Solarstrom macht - ohne Daten nach aussen zu senden.
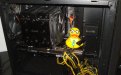
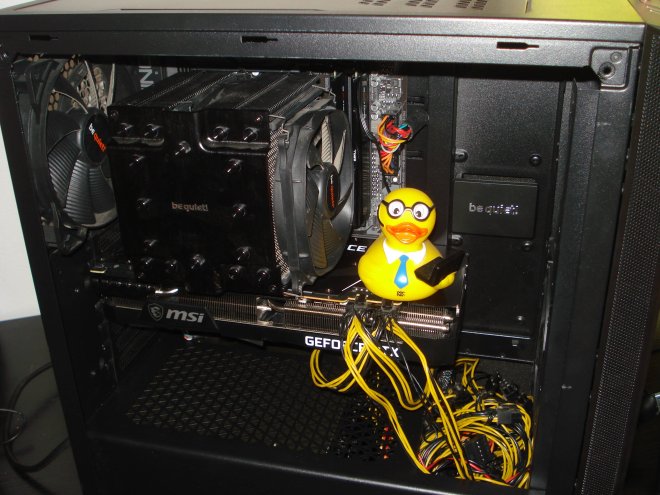
Eigentlich wollte ich einen 13 Jahre alten HP Notebook elitebook 840 g1 im Homeoffice durch einen leistungsstarken PC ersetzen. Denn zum Entwickeln brauche ich manchmal mehr Ressourcen als 16GB RAM und 4 CPU Kerne. Nachdem die Hardwarepreise gerade einen Höhenflug erleiden, habe ich mich am Gebrauchtmarkt umgesehen. Ich habe dann von einem HTL Maturanten einen PC mit einem modernen AMD Ryzen 9 7950X mit 16/32 Cores und 32GB DDR5 RAM abgekauft - er wollte sich damit eine Asien-Reise finanzieren. Von ihm habe ich die Tux-Ente als Bonus dazu erhalten.
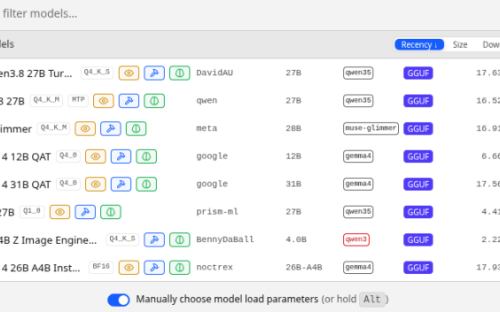
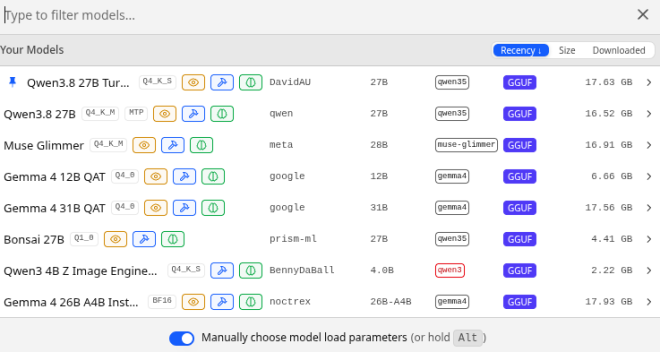
Also ein Debian Trixie mit XFCE installiert (KDE stürzt leider ab obwohl es mir gut gefallen würde, aber ich bin das einfache XFCE eh sehr gewohnt, muss ich mir die Paketkonfilikte nochmal anschauen). Auch ohne GPU konnte ich damit einige Modelle schon testen, mehr als 5-10 Token pro Sekunde gingen so aber nicht. qwen3-4b war etwas schneller als gemma-4-12b-qat und es liessen sich damit durchaus schon einige Aufgaben lösen - mit Geduld.
Welche GPU sollte es denn sein? Also unter 20GB VRAM kann man nur einfachere Modelle fahren und muss man das Kontextfenster klein halten. Zunächst habe ich mit einer RTX 2080 modded mit 22GB VRAM spekuliert, die gab es vor drei Monaten noch um um ca €420.- auf ebay aus HongKong - nun ist sie bereits um € 100.- teurer. Ich war etwas skeptisch, ob der Austausch der DDR6 RAM Chips dann stabil läuft. Es wurde eine NVIDIA RTX 3090 mit 24 GB VRAM, die ich mit einiger Geduld auf willhaben.at noch um € 900.- gebraucht bekommen habe.
Leider war dann das 600W !bequiet Netzteil zu schwach. Der Rechner blieb beim Reasoning einfach stehen und liess sich auch gar nicht mehr einschalten - ein Zeichen für ein "overload" der PSU. Da half nur komplett Strom aus und wieder ein. Ich hab dann um € 60.- gebraucht ein 1800W Netzteil abgeholt, das jemand für eine Mining-Rig mal verwendet hatte (und an die man acht Grafikkarten anschliessen könnte). Ist etwas laut, aber funktioniert jetzt.
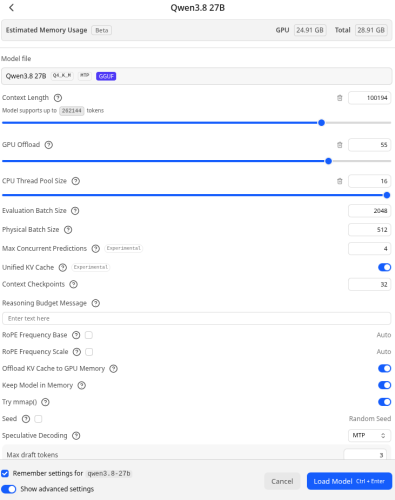
Mit diesem Setup kann ich das qwen 3.8-27B Modell mit einer Kontextlänge von 100000 Tokens fahren (es unterstützt bis 250000 Token). Dieses Modell ist richtig gut, kommt an die "grossen" wie Opus oder Sonnet von Claude schon nahe dran, und läuft mit 40-60 t/s. Auch das muse-glimmer von Meta in seiner 28B Variante läuft darauf gut, dauert mir allerdings etwas zu lange beim Reasoning, da muss ich mich noch mit Parametern spielen.
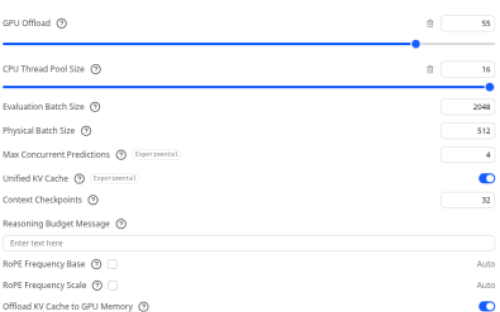
Das GPU offloading habe ich auf 55 eingestellt, damit eben noch Platz ist für andere Grafik-Tasks. Eine zweite Grafikkarte, eine alte RTX 750 mit 2GB RAM hätte ich für die Bildschirme vorgesehen, aber da looped das BIOS beim Start (hatte schon mal funktioniert mit einem anderen Netzteil, muss ich nochmal genauer anschauen).
Als Software verwende ich LM Studio, das einen LLM Server mit dabei hat und an den ich auch OpenCode über den Port 1234 verbinden kann. Ich hatte auch einen eigenen ollama Server installiert, da musste ich aufpassen dass nicht beide gleichzeitig LLMs geladen haben. nvtop oder ollama ps sind gute Werkzeuge um zu sehen was läuft. Dazu gebaut habe ich als MCP libreoffice und ein rzk mit searxng, das ohehin schon am fairkom kubernetes Cluster läuft (eigenes overlay, nicht als public instance konfigurieren sonst lässt es KI bot Anfragen nicht zu).
Der cuda Treiber überlebt leider noch kein suspend und auch kein hibernate - also da muss der PC dann nach getaner Arbeit ganz ausgeschaltet werden. Das muss ich auch nochmal genauer anschauen.
Weitere Experimente folgen, aber mit diesem Setup kann ich mal gut lokal arbeiten. Ich überlege nochmal das Netzteil gegen ein leiseres auszutauschen, oder alternativ den Rechner wo zu "verstecken" (da gäbe es eine Dachkammer über oder einen Atelierraum unter meinem Labor, der könnte dann auch mit KI Aufgaben "geheizt" werden). Und tagsüber verbrauche ich damit nur eigenen PV Strom (ein Solarstromspeicher wäre dann wieder ein eigenes Projekt - einstweilen planen wir einer Energiegemeinschaft beizutreten, um übrigen PV Strom an Nachbarn zu verkaufen oder von einem lokalen Kraftwerk zu beziehen).
Hier nun eine Beispielanfrage an das qwen 3.8-27B Modell
Beschreibe mir den Weg von INnerlaterns Bädle zum Freschenhaus. Den möchte ich morgen wandern siehe https://fairmove.net/@rasos/117350460020481046
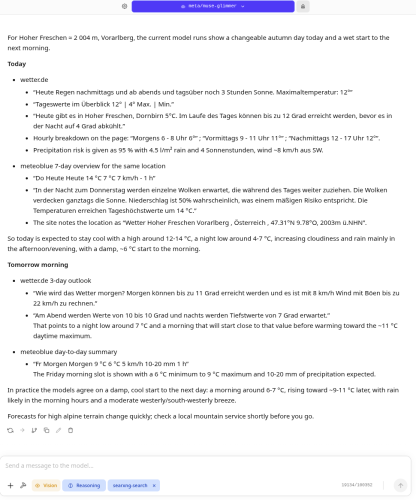
Die Antwort in LM Studio:
Der Fairmove-Track selbst lässt sich leider nicht direkt auslesen (die Seite braucht JavaScript), aber die Strecke von Innerlaterns Bädle zum Freschenhaus ist die klassische Route – hier die Beschreibung:
## Wanderung: Innerlaterns Bädle → Freschenhaus
**Grunddaten:** ca. 5,7–5,8 km | ca. 2:20–2:45 Std. | ca. 690 hm Aufstieg | Schwierigkeit T2 (mittel, aber gut machbar)
**Höhenlage:** Start Gasthaus Bädle (ca. 1.147 m) → Freschenhaus (1.846 m)
### Wegbeschreibung
1. **Start am Gasthaus Bädle** (Bushaltestelle „Innerlaterns Bädle"): Du wanderst ein kurzes Stück auf der Straße Richtung Bad Laterns, bis du auf Höhe eines Parkplatzes **linkerhand auf den markierten Wanderweg** abbiegst (Schilder: Freschenhaus / Hoher Freschen).
2. **Entlang des Garnitzbaches:** Der Weg führt erst durch den Wald, dann über freie Flächen leicht ansteigend hinauf – zuerst zur **Vorderen, dann zur Hintersen Garnitzaalpe** (ca. 30 Min. vom Bädle bis zur ersten Alpe).
3. **Der Steig zur Saluveralpe:** Ab den Alpen wird der Fahrweg zu einem Steig. Er führt überhalb des Bachbetts, unter ein paar **Felsabbrüchen** hindurch, hinauf zur **Unteren Saluveralpe (1.565 m)** – hier sind die steilsten Passagen (ca. 60 Min. von der Alpe).
4. **Letzter Anstieg:** Von dort geht es über freies Gelände, vorbei an der **Oberen Saluveralpe**, in den letzten ca. 45 Min. zum **Freschenhaus (1.846 m)**, das aussichtsreich unterhalb des Hohen Freschen (2.005 m) thront.
### Gut zu wissen für morgen
- **Einkehr/Übernachtung:** Im Freschenhaus kannst du einkehren oder übernachten – am besten vorher kurz anrufen bzw. Verfügbarkeit prüfen.
- **Sehenswürdigkeiten an der Hütte:** Freschenkapelle, die ca. 700 m lange **Freschenhöhle** und ein alpiner Steingarten – alles in der Nähe der Hütte.
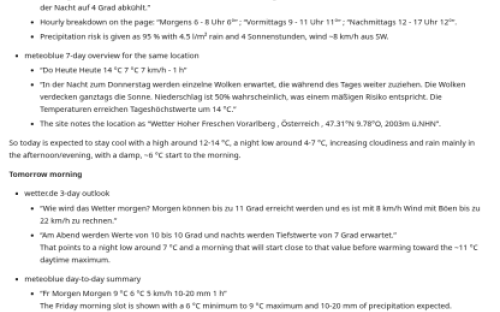
- **Wetter:** Die Hütte liegt hoch, bei Wolkenbildung kann es oben schnell kalt/neblig werden – wettfeste Schicht einpacken.
- **Notruf:** 140 (Alpine Notfälle), 144 (Vorarlberg), 112.
Gute Wanderschaft morgen!
Und hier das Logfile dazu mit der Angabe der Geschwindigkeit für jeden Subtask:
34.30.340.570 I slot print_timing: id 2 | task 668 | prompt processing, n_tokens = 4096, progress = 0.71, t = 5.04 s / 812.88 tokens per second
34.31.992.613 I slot print_timing: id 2 | task 668 | prompt processing, n_tokens = 5273, progress = 0.91, t = 6.84 s / 771.39 tokens per second
34.32.633.568 I slot print_timing: id 2 | task 668 | prompt processing, n_tokens = 5717, progress = 0.99, t = 7.39 s / 773.88 tokens per second
34.32.897.214 I slot print_timing: id 2 | task 668 | prompt processing, n_tokens = 5785, progress = 1.00, t = 7.80 s / 741.43 tokens per second
34.33.437.684 I slot print_timing: id 2 | task 668 | prompt eval time = 7958.35 ms / 5789 tokens ( 1.37 ms per token, 727.41 tokens per second) 34.33.437.687 I slot print_timing: id 2 | task 668 | eval time = 421.00 ms / 16 tokens ( 28.07 ms per token, 35.63 tokens per second) 34.33.437.687 I slot print_timing: id 2 | task 668 | total time = 8379.35 ms / 5805 tokens 34.33.437.688 I slot print_timing: id 2 | task 668 | graphs reused = 643